Apinizer Varken llm-d'ye İhtiyacınız Var mı?
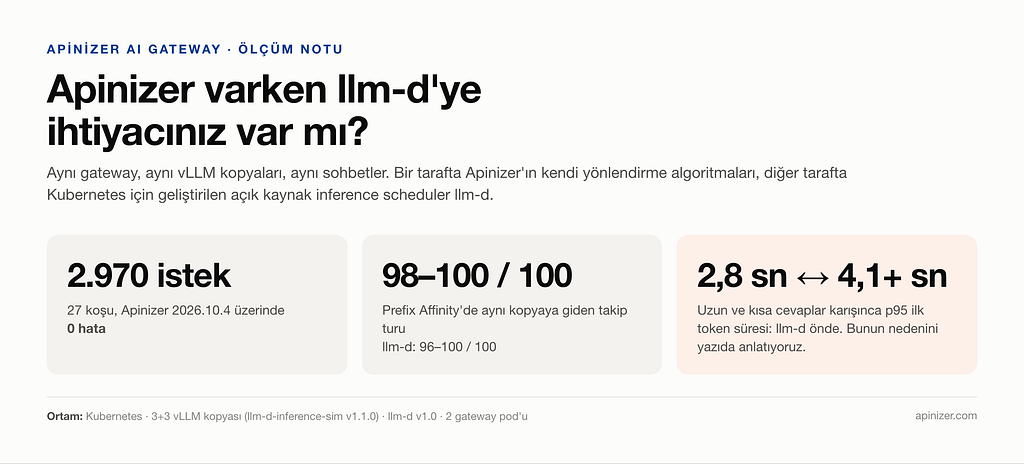
Kısa cevap: çoğu durumda hayır. İhtiyacınız olduğunda da llm-d'yi Apinizer'ın yerine koymuyorsunuz, arkasına ekliyorsunuz. Bu cevaba nasıl vardığımızı rakamlarla anlatıyoruz. llm-d'nin önde olduğu tek senaryo da bunlara dahil.
Kendi vLLM sunucularını işleten bir müşterimiz bu hafta bize şunu sordu: "llm-d'yi Apinizer'a entegre etmeli miyiz?"
Soru yerinde. llm-d, Kubernetes için geliştirilen açık kaynak bir inference scheduler. Bir modelin birden fazla vLLM kopyası varsa isteği hangisine göndereceğine o karar veriyor. Bu kararı verirken kopyaların kuyruğuna, KV-cache doluluğuna ve prompt'un hangi kopyanın önbelleğinde olduğuna bakıyor.
LLM servis ederken maliyetin önemli bir kısmı bu karardan çıkıyor. Sohbetin yeni turu önceki turun önbelleğini taşıyan kopyaya giderse ilk token neredeyse hemen gelir. Başka bir kopyaya düşerse bütün konuşma baştan hesaplanır.
Apinizer AI Gateway'de bu işi yapan bir algoritma zaten var: Prefix Affinity, yani aynı sohbeti aynı kopyaya yapıştıran yönlendirme. "Gerek yok" demek kolaydı. Biz önce ölçmeyi seçtik.
Aynı gateway'den, aynı vLLM kopyalarına, aynı sohbetleri iki yoldan gönderdik. Bir yolda kopyayı Apinizer seçti, öbür yolda llm-d. Ölçümleri üç sürüm adayı boyunca tekrarladık. Bu yazıdaki sonuçlar yayındaki Apinizer 2026.10.4 ile alındı. Sonuçlardan biri llm-d'nin lehine; onu da olduğu gibi aktarıyoruz.
İkisi Aynı Katmanda Değil
"llm-d mi, Apinizer mı?" sorusu kulağa doğal geliyor ama yanlış kurulmuş. İki ürün farklı katmanlarda çalışıyor.
llm-d bir kopya seçicisi. Tek bir model havuzunun önünde durur ve "bu istek 3 kopyadan hangisine gitsin?" sorusunu cevaplar.
Apinizer AI Gateway bir kontrol katmanı. Kimlik doğrulama, kota, token bütçesi, guardrail, PII maskeleme, loglama, maliyet takibi ve modele göre yönlendirme burada yapılır. Hangi sağlayıcının, hangi modelin ve hangi havuzun kullanılacağına da burada karar verilir. Kopya seçimi bu katmanın işlerinden yalnızca biri.
Dolayısıyla gerçek soru şu: Kopya seçimi için gateway'in hedef havuzu yeterli mi, yoksa havuzun arkasına ayrı bir scheduler eklemek mi gerekiyor? Biz bunu ölçtük.
Nasıl Ölçtük
Test düzeneğini olabildiğince adil kurduk; iki yol arasındaki tek fark kopyayı kimin seçtiği.
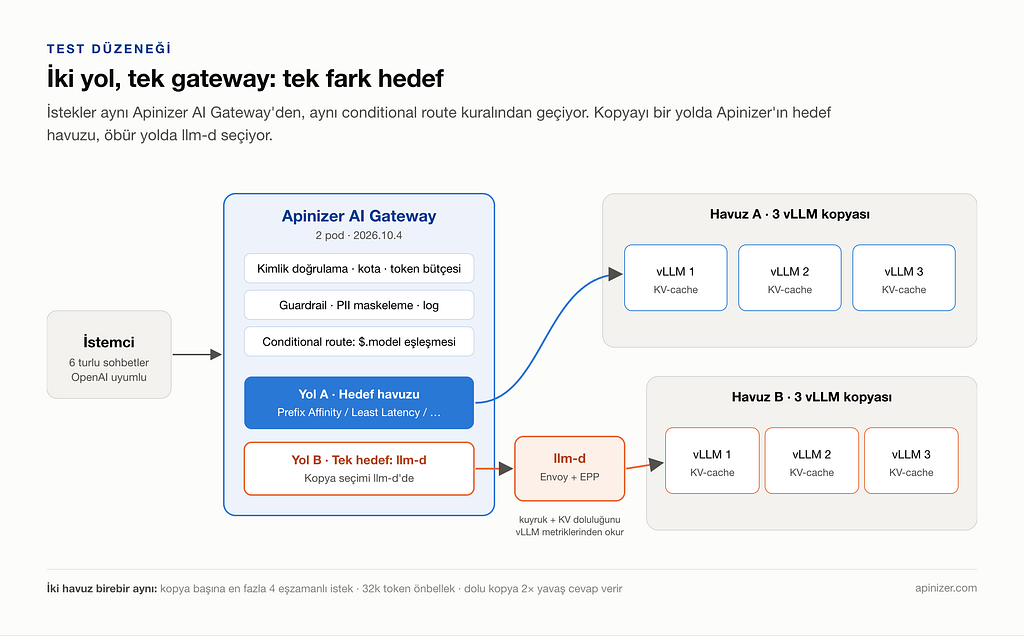
Altyapı. Kubernetes üzerinde iki ayrı model havuzu kurduk, her birinde 3 vLLM kopyası var. Kopyalar llm-d projesinin kendi vLLM simülatörüyle (llm-d-inference-sim v1.1.0) çalışıyor ve KV-cache simülasyonu açık.
İki havuzun ayarları birebir aynı:
- Kopya başına en fazla 4 eşzamanlı istek. Yükü bilerek sıkıştırdık; kopyalar dolunca yanlış yönlendirmenin bedeli görünür oluyor.
- Kopya başına yaklaşık 32 bin token önbellek.
- Önbellekte olmayan her prompt token'ı ilk token süresini (TTFT) uzatıyor.
- Dolu bir kopya 2 kat yavaş cevap veriyor.
llm-d v1.0 olarak, Envoy ve EPP (endpoint picker) bileşenleriyle çalışıyor. Apinizer AI Gateway 2026.10.4, 2 pod üzerinde.
Yönlendirme. İki yol da aynı gateway'den ve istek gövdesindeki model alanına bakan aynı conditional route kuralından geçiyor:
- Yol A: Route'un hedef havuzunda 3 kopya tanımlı, kopyayı Apinizer'ın algoritması seçiyor.
- Yol B: Route'un tek hedefi llm-d, kopyayı llm-d seçiyor.
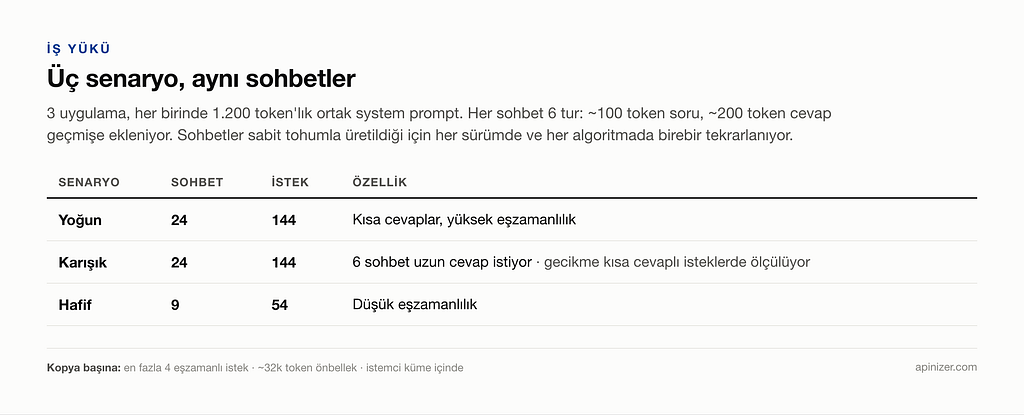
İş yükü. 3 uygulama var, her birinin 1.200 token'lık ortak bir system prompt'u var. Her sohbet 6 tur sürüyor: her turda yaklaşık 100 token'lık bir soru gidiyor ve yaklaşık 200 token'lık cevap geçmişe ekleniyor. Sohbetler sabit bir tohumla üretiliyor, böylece her sürümde ve her algoritmada birebir aynı sohbetler gönderiliyor. İstemci küme içinde çalıştığı için internet gecikmesi ölçüme karışmıyor.
Neyi ölçtük.
- Sohbet takibi: Takip turunda önceki turun prompt'unun en az %90'ı önbellekten geldiyse "aynı kopyaya gitti" saydık. Sonucu "100 turdan kaçı" diye veriyoruz. Bu bir başarı oranı değil. Round Robin ve Least Latency sohbet takibi için tasarlanmadı; bunlarda düşük çıkması beklenen bir durum.
- Kopya başına istek: Gateway hangi kopyanın cevap verdiğini göstermiyor. Bu yüzden her kopyanın kendi vLLM sayacını testten önce ve sonra okuduk.
- TTFT p50 ve p95: İstemci tarafında ölçtük.
Son sürümde 27 koşuda 2.970 istek gönderdik. Hiçbir istek hata dönmedi.
Sonuç 1: Sohbet Takibinde llm-d ile Aynı Seviyede
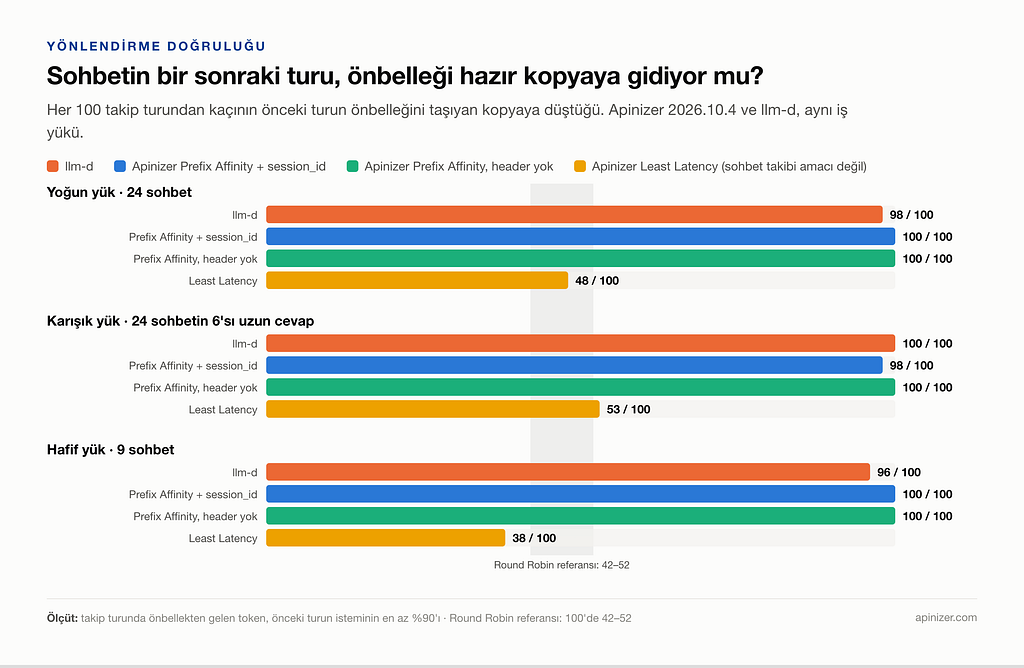
Prefix Affinity iki şekilde çalışıyor. İstemci session_id header'ı gönderirse sohbeti bu kimlikten tanıyor. Header gelmezse system mesajı ile ilk kullanıcı mesajından bir anahtar üretiyor.
Üç senaryonun hepsinde, iki varyantta da 100 takip turundan 98–100'ü önbelleği hazır kopyaya gitti. llm-d'de bu sayı 96–100.
Karşılaştırma için: sohbet takibi amaçlamayan Least Latency'de bu sayı 38–53, Round Robin'de 42–52.
Yani KV-cache yerelliği için ayrı bir scheduler kurmak şart değil. Gateway'deki algoritma bu işi aynı doğrulukla yapıyor.
Sonuç 2: Yük Dağılımı, Failover ve Algoritma Çeşitliliği
Sohbet takibi işin yarısı. Öbür yarısı, hiçbir kopyanın boşta kalmaması ve hiçbirinin boğulmaması.
Least Latency kopyaları dengeli kullandı. Kopya başına istek yoğun yükte 44 / 48 / 52, karışık yükte 33 / 51 / 60 oldu. Hafif yükte ard arda iki koşuda 9 / 21 / 24 ve 15 / 19 / 20 çıktı; hiçbir kopya boş kalmadı.
Prefix Affinity, dağıtımı sohbet anahtarına göre yapıyor. Bu yüzden karışık yükte iş 18 / 60 / 66 ve 24 / 53 / 67 şeklinde bölündü. llm-d yeni sohbeti en boş kopyaya koyduğu için aynı yükte 48 / 48 / 48 dağıttı. Sonuç 3'teki gecikme farkı tam olarak buradan doğuyor.
Failover sorunsuz çalıştı. Havuza bağlantıyı reddeden dördüncü bir üye ekledik. Round Robin, Least Latency ve Prefix Affinity'de 48'er isteğin 48'i diğer üyelerden başarıyla döndü; istemci tek bir hata görmedi.
Aynı proxy'de iki route birbirini etkilemedi. İlk eşleşen route kazandı ve route'lar birbirinin sayaçlarını bozmadı. Round Robin route'u istekleri 17 / 18 / 19 olarak eşit dağıttı. Prefix Affinity route'u turların 100'ünü aynı kopyada tuttu.
Takma adlı modeller de doğru izlendi. İstemci modeli takma adla gönderdiğinde de algoritmalar trafiği gördü. Dağılımlar, tam adla gönderilen trafikle aynı aralıkta kaldı.
Bir önceki sürüm adayında bütün algoritmaları ayrıca yaklaşık 100'er istekle denedik:
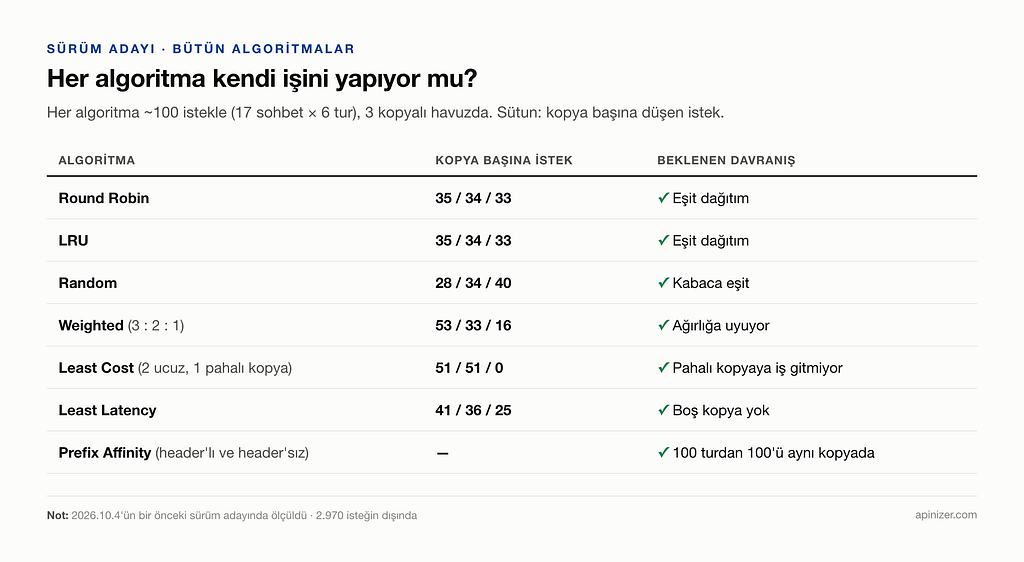
llm-d tek bir problemi çözüyor: kopya seçimi. Gateway'de ise maliyete, ağırlığa ve gecikmeye göre yönlendirme de aynı yerde duruyor. "Bu model pahalı kopyaya yalnızca gerektiğinde gitsin" gibi kurallar da burada tanımlanıyor.
Sonuç 3: Gecikme. İstisna Burada
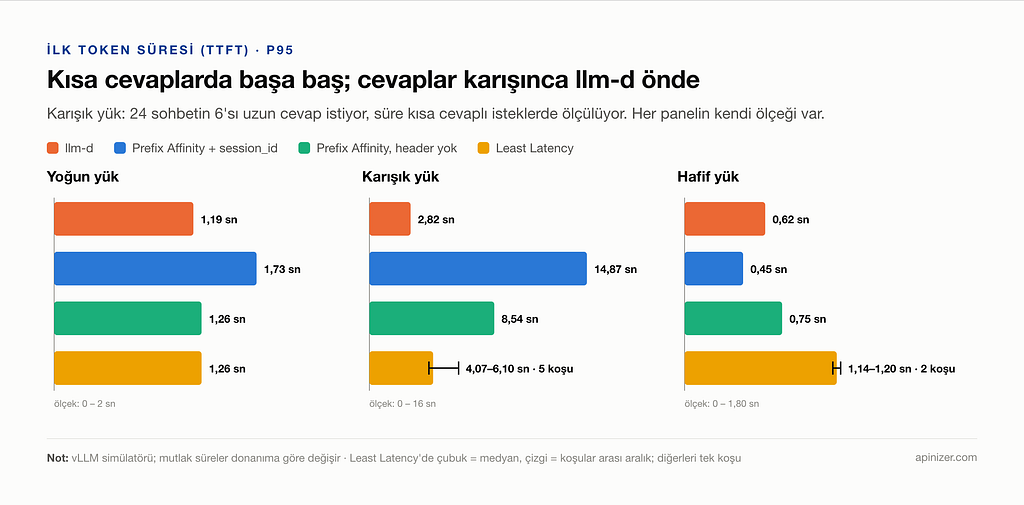
Kısa cevaplı yükte fark yok.
- Yoğun senaryoda llm-d 1,19 sn; Prefix Affinity (header yok) ve Least Latency 1,26 sn.
session_id'li Prefix Affinity 1,73 sn. - Hafif senaryoda en hızlısı
session_id'li Prefix Affinity: 0,45 sn. llm-d 0,62 sn.
Uzun ve kısa cevaplar karışınca llm-d önde.
- Karışık senaryoda kısa isteklerin p95'i llm-d'de 2,82 sn.
- Apinizer'da en iyi sonucu Least Latency veriyor: aynı adla gönderilen beş koşuda 4,07–6,10 sn. Takma adla gönderilen dört koşuda bu aralık 5,3–14,9 sn'ye kadar açıldı.
- Prefix Affinity'de bu süre 8,54 sn (header yok) ve 14,87 sn (
session_id).
Bunun nedeni basit:
- llm-d her vLLM kopyasının kuyruk derinliğini ve KV doluluğunu vLLM metriklerinden okuyor ve yeni sohbeti boş kopyaya koyuyor. (Bu yeteneği de yol haritamıza aldık.)
- Gateway kopyanın içini görmüyor. Kendi ölçtüğü gecikmeye ve kopyada o anda süren istek sayısına bakıyor. Kaç istek olduğunu biliyor, ama bu isteklerin kısa mı uzun mu olduğunu bilmiyor.
- Prefix Affinity'de ağır sohbetler de kendi kopyalarına bağlı kalıyor. Aynı kopyaya düşen kısa istekler onların arkasında bekliyor.
Yerellik ile yük dengesi arasında gerçek bir takas var. llm-d bu takası kopyanın içini görerek çözüyor.
- Karışık senaryodaki p95 koşudan koşuya ciddi oynuyor; aynı algoritma aynı yükte bir koşuda 4, öbüründe 15 saniye verebiliyor. llm-d ve Prefix Affinity değerleri tek koşudan geliyor. Bunları kesin ölçüm değil, yön gösteren bir sinyal olarak okuyun.
- Gateway'in kendi eklediği süreyi bir önceki sürüm adayında ayrıca ölçtük. Aynı kopya seçimini gateway'li ve gateway'siz koşturduk; hafif yükte aradaki fark 0,02–0,08 saniye çıktı.
2026.10.4'te Yönlendirme Nasıl Değişti
Bu ölçümü bir kerelik bir karşılaştırma olarak değil, sürüm sürecimizin bir parçası olarak kurduk. Her sürüm adayından sonra aynı sohbetleri aynı düzenekte tekrar koştuk. 2026.10.4'teki yönlendirme iyileştirmeleri bu ölçümlerin sonucunda geldi:
- Her sohbet kendi anahtarını alıyor. Header gelmediğinde anahtar artık system mesajı ile ilk kullanıcı mesajının tamamından üretiliyor. Uzun ortak system prompt'lar sohbetleri tek kopyada toplamıyor.
- Sıcak nokta koruması anlık yüke bakıyor. Prefix Affinity'nin yük sınırı artık kopyada o anda süren istek sayısını kullanıyor. Az yükte sohbet gereksiz yere taşınmasın diye küçük bir pay bırakılıyor. Sınır hâlâ istek sayısına bakıyor, cevap uzunluğuna değil. Karışık yükteki gecikme farkı bu yüzden sürüyor (Sonuç 3).
- Least Latency yükü dengeli dağıtıyor. Bir süredir ölçülmemiş ve boşta duran kopya ara sıra yeniden deneniyor. Böylece eski bir yavaş ölçüm o kopyayı kalıcı olarak dışarıda bırakmıyor.
- Takma adlar asıl modelle eşleşiyor. Takma adla gelen istekler, havuz üyesinin asıl model kimliğiyle ölçülüyor. Algoritmalar bu trafiği de görüyor.
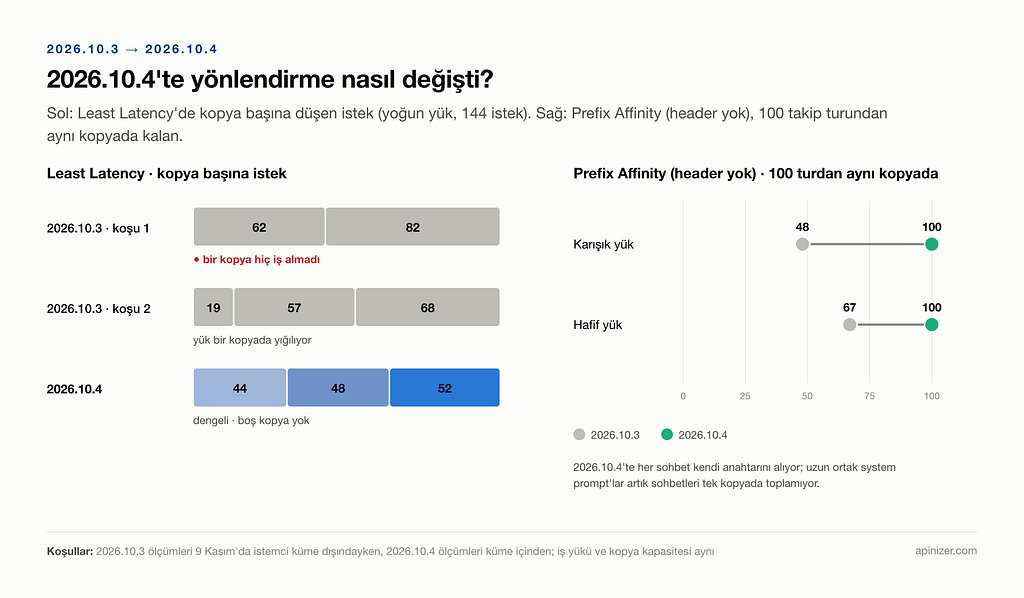
Fark en net iki yerde görünüyor:
- Least Latency, yoğun yük: Kopya başına istek 0 / 62 / 82'den 44 / 48 / 52'ye geldi.
- Prefix Affinity (header yok): 100 takip turundan aynı kopyada kalan sayısı karışık yükte 48'den 100'e, hafif yükte 67'den 100'e çıktı.
Sürüm adaylarından biri hafif yükte bir kopyayı yine boş bıraktı (0 / 25 / 29). Bunu yayından önce yakaladık. Yayındaki sürüm aynı yükte iki ayrı koşuda 9 / 21 / 24 ve 15 / 19 / 20 dağıttı.
llm-d bu süreçte bizim için bir rakip değil, kendi algoritmalarımızı ölçtüğümüz bir referans oldu.
llm-d'yi Eklemeye Karar Verirseniz, Nereye?
Bazı ortamlarda llm-d mantıklı bir seçim. Bu durumda doğru yer gateway'in arkası:
- Route hedefi: İlgili modelin route'unda hedef llm-d olur ve kopya seçimini llm-d yapar.
- Gateway'de kalanlar: Kimlik doğrulama, kota, token bütçesi, PII maskeleme, loglama ve modele göre yönlendirme.
- Failover: Eski doğrudan vLLM adresleri havuzda yedek olarak kalır. llm-d düşerse trafik doğrudan kopyalara geçer.
- Kurulum yeri: Gateway zaten Kubernetes'teyse aynı cluster'da ayrı bir namespace yeterli. Ayrı bir sunucuya, GPU'ya ya da vLLM sunucularına kurulum gerekmiyor.
- vLLM'ler Kubernetes dışındaysa: llm-d kopya listesini bir dosyadan okuyor. Kubernetes'e özgü otomatik keşif devre dışı kalıyor ve ölen bir kopyayı listeden çıkarmak operasyon ekibine düşüyor. Kurmadan önce bunu hesaba katın.
llm-d'yi gateway'in yerine koymak ise kimlik, bütçe ve denetim katmanını kaybetmek demek. llm-d bu katmanı sağlamıyor; zaten böyle bir iddiası da yok.
Karar
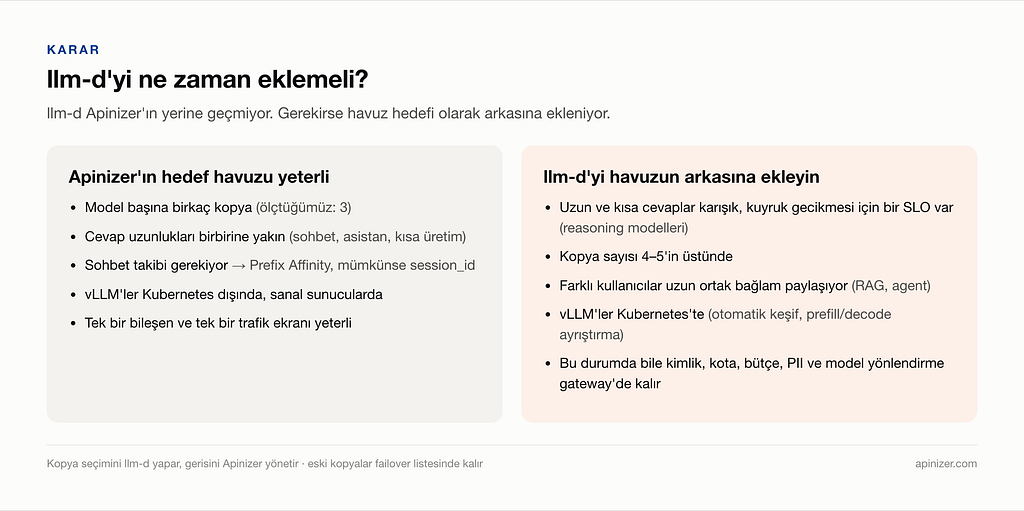
Apinizer'ın hedef havuzu yeterli, eğer:
- Model başına birkaç kopyanız varsa (biz 3 kopyayla ölçtük),
- Cevap uzunlukları birbirine yakınsa,
- Sohbet takibi istiyorsanız: Prefix Affinity kullanın; istemcileriniz
session_idgönderebiliyorsa daha da iyi.
llm-d'yi havuzun arkasına eklemeyi düşünün, eğer:
- Uzun ve kısa cevaplar karışıyorsa ve kuyruk gecikmesi için bir SLO'nuz varsa. Bunu ölçtük.
Aşağıdaki maddeleri ise ölçmedik. llm-d'nin tasarımından ve kendi deneyimimizden çıkardığımız değerlendirmeler:
- Kopya sayısı 4–5'i geçtikçe kuyruk görünürlüğünün değeri artar.
- Farklı kullanıcılar uzun ortak bağlam paylaşıyorsa (RAG, agent), blok düzeyinde prefix eşleşmesi fark yaratabilir.
- vLLM'leriniz Kubernetes'teyse llm-d'nin otomatik keşif ve prefill/decode ayrıştırma gibi asıl yetenekleri devreye girer.
İki durumda da kimlik, kota, bütçe, guardrail ve model yönlendirmesi gateway'de kalıyor.
Bu Ölçümün Sınırları
- Simülatör: Ölçümler gerçek GPU'da değil, llm-d'nin vLLM simülatöründe alındı. Simülatörün tokenizer'ı gerçek bir tokenizer değil, bu yüzden llm-d'nin blok düzeyindeki prefix eşleşmesi tam gücüyle sınanmadı. Mutlak süreler donanıma göre değişir. Bu sonuçlar algoritmalar arasındaki farkı ve sohbet takibi doğruluğunu gösteriyor.
- Ölçek: Ölçtüğümüz havuzlarda 3'er kopya vardı.
- Tekrar sayısı: Çoğu sonuç tek koşudan geliyor. Sohbet takibi ve dağılım tekrarlarda tutarlı kaldı. Karışık yükteki p95 ise koşudan koşuya oynuyor.
Kapanış
"Yeni bir altyapı bileşeni gerekli mi?" sorusuna iki şekilde cevap verilebilir: popülerliğine bakarak ya da ölçerek. Biz ölçtük.
Sonuç: sohbet takibinde llm-d ile aynı seviyedeyiz, kısa cevaplı yükte başa başız. Uzun ve kısa cevapların karıştığı yükte kuyruk gecikmesinde llm-d önde; bunu kabul ediyoruz ve gerektiğinde llm-d'yi gateway'in arkasına eklemenin yolunu da gösterdik.
Bu ölçümleri her sürüm adayında tekrarlamaya devam ediyoruz.
Siz LLM trafiğinizde kopya seçimini nerede yapıyorsunuz: gateway'de mi, ayrı bir scheduler'da mı, yoksa bu soruyu henüz sormadınız mı?
Hedef havuzu, yönlendirme algoritmaları ve Prefix Affinity ayarları için Yönlendirme ve Failover sayfasına bakabilirsiniz.